
Acabo de contar las tareas pendientes de GNB Labs. Son 1,082.
No es que no las haya escrito bien. Es que de esas 1,082, 949 no dicen si las puede hacer un agente de IA o si necesitan que alguien piense. El 88%. Otras 819 no dicen cómo sabremos que quedaron listas, y 201 no tienen prioridad.
Las medí contra la API de Linear. No es una estimación.
Y aquí está lo que me molesta de verdad: no es desorden. Es que cada mañana, la pregunta "¿qué agarro hoy?" no se puede contestar sin leerse el tablero completo. Como nadie se va a leer mil tareas, lo que pasa en realidad es que agarras las cinco que te acuerdas.
Ya intenté arreglarlo con IA, y por eso sé por qué no funcionó
La respuesta obvia es pasarle el tablero a Claude y pedirle que lo ordene. La probé.
Funciona, y no la puedo usar seguido. Mil tareas es mucho texto: la corrida tarda minutos y cuesta dólares. Cuando algo cuesta dólares y minutos, lo corres una vez, te sientes productivo, y no lo vuelves a correr. Dos semanas después el tablero creció otras 80 tareas y volviste al mismo lugar.
El problema nunca fue que la IA no pudiera clasificar. El problema es que clasificar era caro, y lo que es caro no se vuelve hábito.
Hay una razón técnica detrás. Cuando le pides a un modelo como Claude que clasifique, el modelo escribe: razona en voz alta, arma una explicación, redacta la respuesta. Tú solo querías la palabra "agente" o la palabra "humano", pero pagaste el ensayo completo. Es como contratar a un abogado para que te diga si un semáforo está en rojo. Va a acertar, y te va a mandar factura por la consulta.
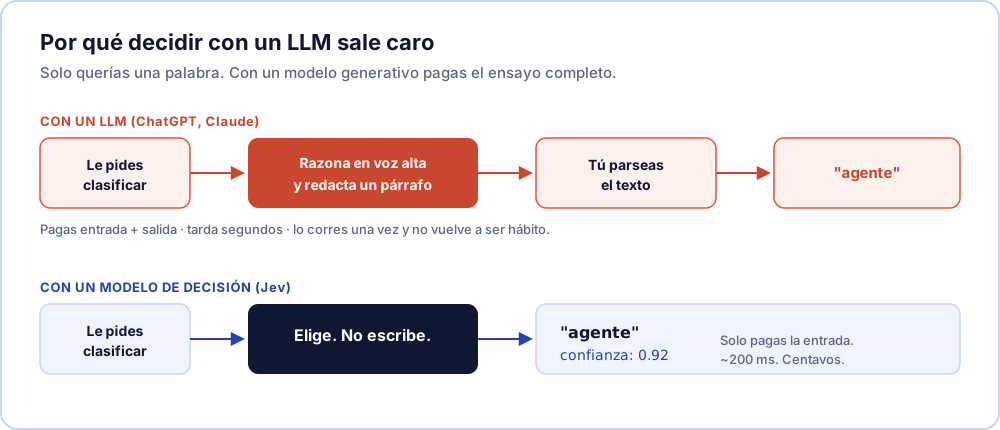
Salió un modelo que solo decide
El 15 de septiembre salió Jev, de TypeSafe AI. Lo raro es lo que no hace: no genera texto.
Para el que llega sin contexto: Jev es un motor de decisión. ChatGPT y Claude escriben párrafos y a veces inventan datos. Jev no escribe nada: recibe información y contesta con una de las opciones que tú definiste, más la probabilidad de cada una. Sirve para clasificar, rutear y calificar. Para redactar no sirve.
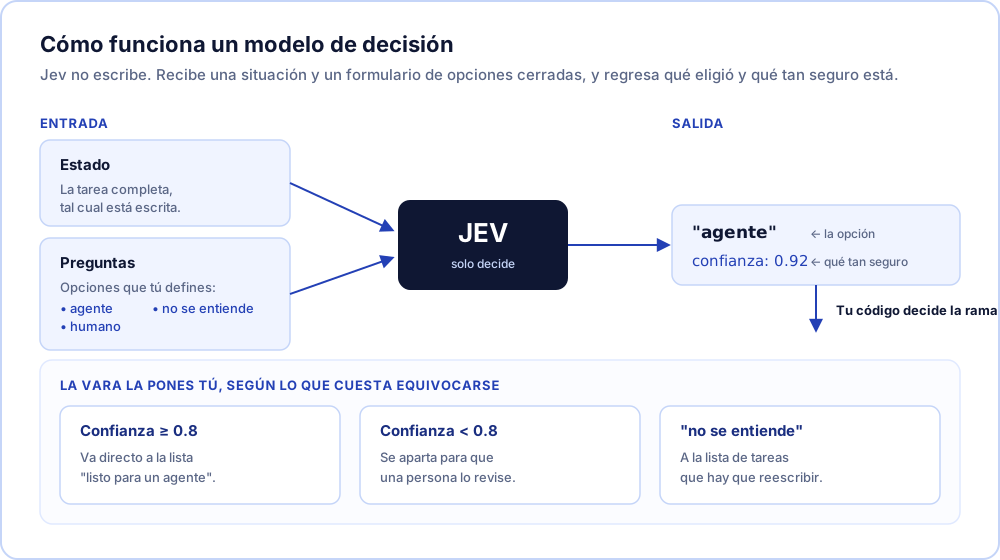
No conversa. No le preguntas nada abierto. No razona en voz alta. Le das una situación y un formulario de preguntas con opciones cerradas, y te regresa cuál opción eligió y qué tan seguro está.
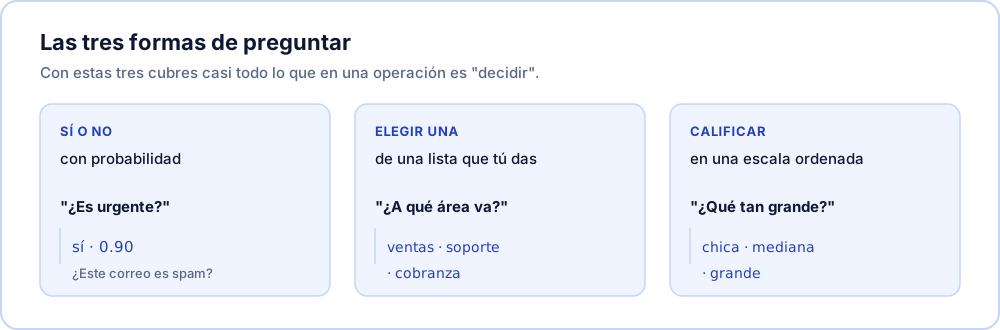
Acepta tres formas de pregunta, y con esas tres cubre casi todo lo que en una operación es "decidir":
- Sí o no, con la probabilidad de que sea sí. ¿Esto es urgente? ¿Este correo es spam?
- Elegir una de una lista que tú defines. ¿A qué área va este ticket: ventas, soporte o cobranza?
- Calificar en una escala ordenada que tú defines. ¿Qué tan grande es esta tarea: chica, mediana o grande?
Un ejemplo de mi propio tablero. Le paso una tarea completa y le hago una pregunta de "elegir una":
{
  "state": "<la descripción completa de la tarea>",
  "questions": {
    "quien_la_hace": {
      "type": "choice",
      "criteria": {
        "agente": "Todo lo necesario está escrito. Un agente lo termina solo.",
        "humano": "Requiere juicio, una decisión de negocio, o hablar con alguien.",
        "no_se_entiende": "La tarea no dice suficiente para saberlo."
      }
    }
  }
}
Y me contesta agente, con 92% de probabilidad. Nada más. No me explica por qué, no me escribe un párrafo, no me sugiere nada.
Eso es exactamente lo que yo quería.
La diferencia práctica está en el precio: cobra la entrada a 0.042 dólares por millón de tokens y no cobra la salida, porque no hay salida que cobrar. No hay párrafo.
Hay otra cosa que cambia y tardé en ver: este modelo no puede inventar una categoría. Las opciones se definen antes de llamarlo. Si le doy tres, contesta una de esas tres. No existe la posibilidad de que me regrese algo que no pedí, que es la mitad de los dolores de cabeza de trabajar con IA generativa.
Ojo con lo que eso no garantiza: que no invente una opción no significa que elija la correcta. Puede contestarte una de tus tres opciones, con 88% de confianza, y estar equivocada. La forma de la respuesta está a salvo; el juicio no. Esa distinción parece un detalle y es justo donde vive el trabajo, como se ve más abajo.
Así se ve el flujo completo, de la tarea a la decisión:
Cómo lo monté, en tres decisiones
Lo dejé escrito como parte de nuestra fábrica de software interna, para que corra igual en todos los proyectos. Tres decisiones, y la tercera es la que más me costó aceptar.
1. El modelo propone. Una persona aplica.
Podría dejarlo reetiquetando las 1,082 tareas solo. No lo voy a hacer.
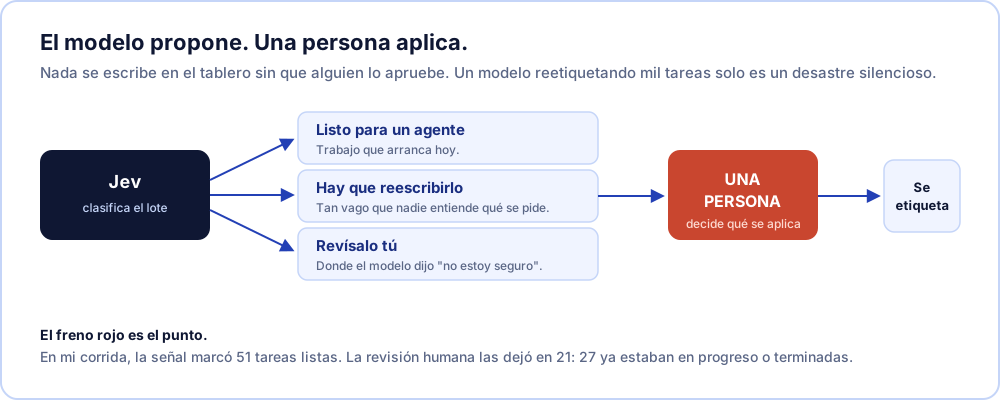
Un modelo equivocándose en mil tareas sin que nadie vea es un desastre silencioso: para cuando lo notas, ya está en todo el tablero y no sabes cuáles tocó bien. Así que entrega tres listas y se detiene:
- Listo para un agente — trabajo que arranca hoy.
- Hay que reescribirlo — está tan vago que ni el modelo ni un humano entienden qué se pide.
- Revísalo tú — donde el modelo dijo "no estoy seguro".
Esa tercera lista es la que más me gusta. Un modelo que sabe decir "no sé" es más útil que uno que siempre contesta.
2. Qué tan seguro tiene que estar depende de qué cuesta equivocarse
Para el tablero interno pido 80% de confianza. Si se equivoca, alguien pierde diez minutos.
Para lo que llega de fuera —formularios, correos, reportes de errores— pido 95%. Ahí un error no cuesta diez minutos: cuesta un cliente que escribió y nadie le contestó porque el modelo lo mandó a la basura.
Misma herramienta, vara distinta, según lo que te cuesta el error. Esto no viene en la documentación de nadie; sale de decidir cuánto te duele.
3. Antes de confiar en las mil, clasifica 20 a mano
Éste es el paso que uno quiere saltarse y es el único que de verdad importa.
Agarras 20 tareas, las clasificas tú, y comparas contra lo que dijo el modelo. Si acierta 18 o más, corres el resto. Si acierta menos, el problema casi nunca es el modelo: es cómo escribiste las opciones. Si tú no puedes explicar en una frase qué distingue "agente" de "humano", el modelo tampoco va a poder.
Es medir antes de actuar. Sin eso, lo único que automatizaste fue tu opinión.
Ya lo corrí. Esto es lo que pasó
Cuando escribí la primera versión de esto no tenía la llave y lo dije: el sistema estaba listo pero ninguna tarea real había pasado por el modelo. La llave llegó el 18 de septiembre. Lo corrí. Aquí están los números, incluidos los que no me gustaron.
La calibración de 20 me costó tres vueltas. Primera corrida: 15 de 20. No porque el modelo estuviera mal, sino porque yo había escrito "la tarea no dice suficiente" y Jev lo leyó como "la tarea es corta". Reescribí ese criterio y subió a 16. Puse las exclusiones dentro del texto —qué cosas no son de agente aunque lo parezcan— y llegó a 18 de 20. Volví a correrlo: otra vez 18, las mismas dos fallas. No fue suerte.
Las dos que falló eran casos que un humano también discutiría, y en uno de los dos Jev contestó con 40% de confianza contra 46%. Casi un volado. El modelo no fingió seguridad que no tenía, y eso vale más que el acierto.
El lote completo: 1,082 tareas clasificadas en 29 segundos, con 205 milésimas de segundo por llamada y cero errores. Costó 0.067 dólares, como 1.2 pesos.
Había estimado 0.015. Salió 4.4 veces más caro, y la causa está medida: las descripciones reales de mis tareas son bastante más largas que los 330 tokens que la documentación usa de ejemplo. El orden de magnitud es el mismo —barrer el tablero entero cuesta menos que un café—, pero mi estimado estaba abajo y prefiero decírtelo a que lo descubras tú.
El número que de verdad importa: 51 contra 21
La señal automática marcó 51 tareas listas para soltarle a un agente hoy. Al revisarlas a mano quedaron 21.
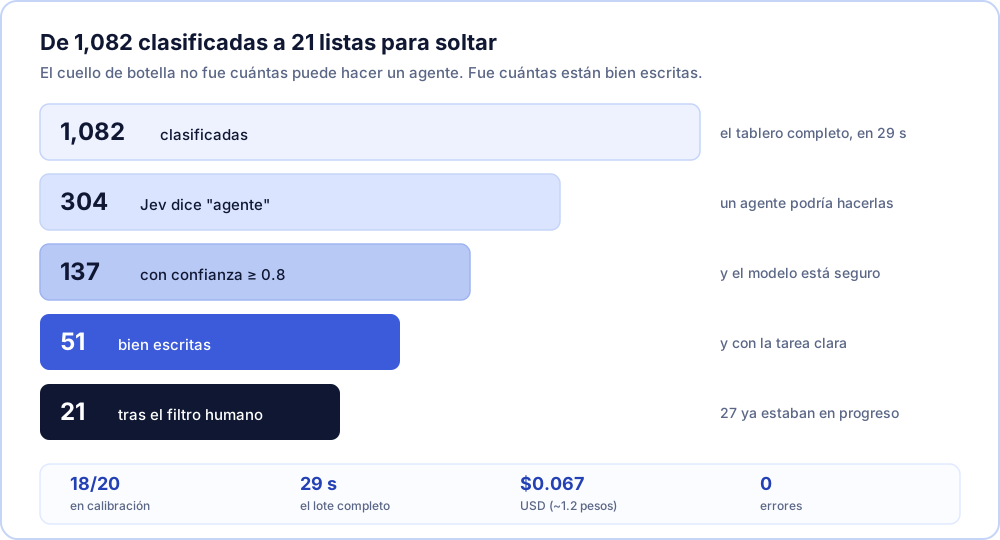
¿Qué pasó con las otras 30? 27 ya estaban en progreso o terminadas esperando validación —etiquetarlas de "listo para empezar" habría mandado a alguien a rehacer trabajo hecho—, y 3 eran demasiado grandes o eran un plan disfrazado de tarea. La señal del modelo no bastaba. El filtro humano es el que evitó el error.
Ahí está la lección que no esperaba: el cuello de botella no era cuántas tareas puede hacer un agente. Es cuántas están escritas lo bastante bien para soltárselas. El 57% de mi tablero está tan mal redactado que ni un agente ni un humano sabe qué se pide. Clasificar salió barato. Escribir bien las tareas sigue costando, y eso ninguna IA lo arregla por ti.
Una pregunta que le hice y no servía
Le pedí a Jev que juzgara, tarea por tarea, si "seguía teniendo sentido tenerla abierta". La idea era encontrar candidatas a cerrar. No funcionó.
El número nunca bajó de 0.38 ni pasó de 0.77. No separaba nada: una tarea de hace seis meses puntuaba casi igual que una de la semana pasada. La causa fue mía: le pedí a un modelo que decidiera si algo es obsoleto sin darle con qué compararlo. No sabe qué herramientas dejamos de usar. Estaba adivinando, y adivinaba "sí" con tibieza.
La obsolescencia no se pregunta, se detecta con datos que ya tienes: días sin moverse, si la tarea nombra rutas o herramientas que ya no existen. Retiré esa pregunta. Un modelo de decisión sirve para juzgar lo que le pones enfrente, no para adivinar lo que no le diste.
Lo que sigue sin estar medido
Los multiplicadores que anda circulando —que Jev es 193 veces más rápido y 444 veces más barato que un LLM— son del fabricante sobre sus propios casos. No corrí esa comparación contra un LLM sobre mi mismo lote, así que no los repito como míos. Sirven para el orden de magnitud, no como promesa.
Y falta el único número que de verdad cierra el círculo: si esas 21 tareas "listas para agente" un agente de verdad las termina sin atorarse. Eso se mide soltando una y viendo qué pasa. Cuando lo haga, lo publico, me vaya bien o mal.
Dónde esto sí aplica en un negocio normal
Si no tienes mil tareas en un tablero, el ejemplo se siente lejano. La forma de encontrar dónde aplica es ésta:
Busca el lugar donde alguien de tu equipo lee cosas para decidir a dónde van. No para resolverlas: para decidir a dónde van.
- Quien revisa los correos que entran y decide cuáles son de venta, cuáles de soporte y cuáles basura.
- Quien lee los formularios del sitio y decide a cuáles vale la pena contestar hoy.
- Quien clasifica facturas, tickets o solicitudes antes de pasarlas.
Ese trabajo es puro decidir con información enfrente. Es exactamente lo que este tipo de modelo hace por centavos, en menos de un segundo.
Y ojo con lo que no es: si la respuesta correcta es un párrafo —redactar la contestación, explicarle al cliente, escribir el resumen— eso sigue siendo trabajo de un modelo generativo. Ahí Jev no sirve.
La regla corta con la que me quedé: un modelo de decisión decide, uno generativo redacta. Usar el generativo para decidir es caro. Usar el de decisión para redactar es imposible. Lo bueno es que se llevan bien: el generativo escribe la respuesta, el de decisión decide a quién va y qué tan urgente es.
Lo que haría yo esta semana si fuera tú
Uno solo, y toma menos de una hora:
Escribe en una hoja las tres o cuatro categorías en las que alguien de tu equipo clasifica algo todos los días, y al lado, en una frase, qué distingue una de otra.
Si logras escribirlo, ya tienes lo único difícil de todo esto: el resto es conectar la herramienta. Mi calibración pasó de 15 a 18 aciertos solo por reescribir esas frases, no por cambiar el modelo. Ahí está el trabajo de verdad.
Y si no logras escribirlo, acabas de encontrar algo más valioso: la razón por la que esa clasificación sale distinta según quién la haga y qué día sea. Eso no lo arregla ninguna IA.
Corrí la barrida completa: 1,082 tareas, 18 de 20 en calibración, 7 centavos de dólar. El siguiente número que me falta es cuántas de las 21 "listas para agente" termina un agente sin atorarse, y lo publico cuando lo tenga. Si quieres ver cómo montamos este tipo de sistemas adentro de una operación, platícame qué estás intentando resolver.


